 TM
Fusion Max
高性能编码、智能体与文档分析,兼顾成本效率。
网页开发文本分析办公任务
1M上下文窗口
128K最大输出
标准价格 / 每百万词元输入 $3 · 输出 $20严格超过 200K tokens 后适用长上下文价;内部协作 tokens 不计费。
成本为该项评测全部任务的总成本(USD);平均时间为每道任务的平均耗时(分钟)。
* Terminal Bench 4.0 使用 63 题 CPU-only 子集。对照配置:GPT-6 Astra(max)、Claude Fable 5.1(max with fallback)。
↖ 越靠左上越好:以更低的成本,取得更高的成绩。
虚线连接帕累托前沿,表示不同成本下的最佳成绩。
从办公文档、网页编程,到科学问题中的推理。
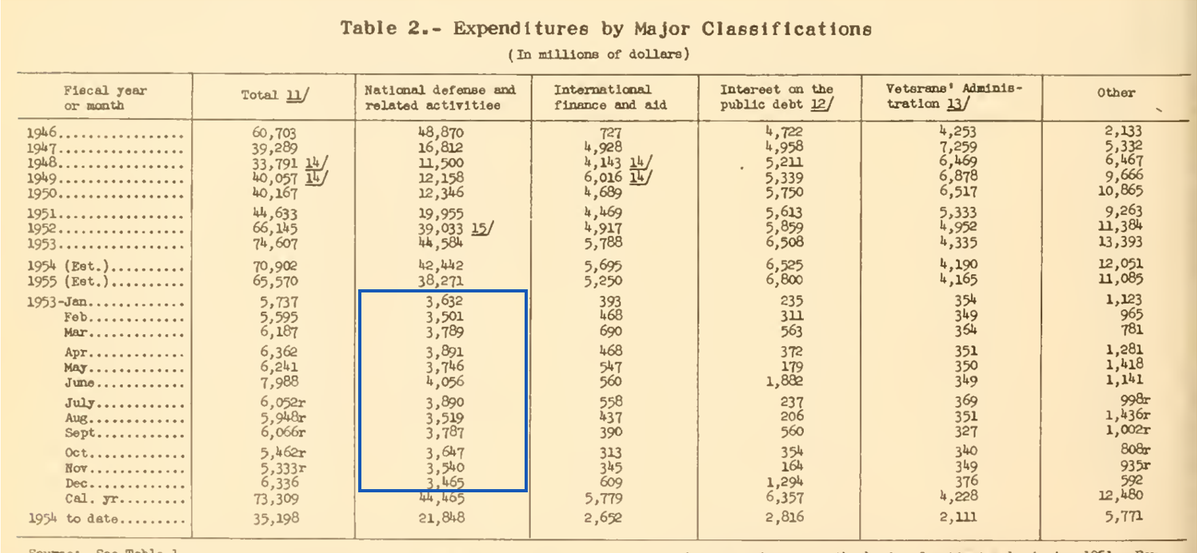
辨认扫描表格中的模糊数字,综合散落多页的文字、图纸与表格,给出有据可查的答案。
查看原文与结果对照 ↗
从角色、关卡到交互逻辑,直接试玩 Fusion 生成的两款浏览器游戏。
试玩生成的作品 ↗
解释纯金属导电现象,分清适用机制与题目排除的条件。
查看研究案例 ↗
从组蛋白乳酰化案例,看模型如何运用跨领域知识。
查看研究案例 ↗
理解侧向抑制过程中,细胞命运如何随条件变化。
查看研究案例 ↗
结合拉乌尔定律的条件,判断气液平衡中的概念边界。
查看研究案例 ↗高性能编码、智能体与文档分析,兼顾成本效率。
面向软件智能体的高性价比编码模型。
个人开发者与企业团队都可以注册自助平台,在 Playground 试用模型,或创建 API Key,接入自己的应用与 Agent。
快速开始 →Fusion Max 2.0 面向需要较强综合能力的任务,包括办公文档、网页编程与多轮 Agent 工作。Fusion Code 1.0 面向软件开发、调试与终端任务,适合更注重调用成本的编码工作流。可以用自己的任务比较输出质量与总费用。
比较模型规格 →Fusion 提供兼容 OpenAI 的 Chat Completions 与 Responses API。按接入文档配置 API 地址、模型 ID 和 Key,即可在支持的客户端中使用。文件读取、浏览器操作与工具执行由你的应用或 Agent 提供。
查看 API 与工具接入文档 →按所选 Fusion 模型的输入、缓存输入与输出费率计费,内部模型协作产生的 tokens 不计费。单个任务的费用取决于实际调用与 token 用量;输入超过 200K tokens 时适用长上下文费率。Max 与 Code 系列均已更新价格。
查看完整价格 →自研路由模型利用大量评测积累的模型能力知识,根据当前任务上下文,在每一步选择适合的模型。在关键步骤,Fusion 会组织多个模型从不同角度分析和求解,再综合结论形成答案。
了解融合原理 →不是。传统路由通常在请求入口选择一个模型。Fusion 能在任务执行过程中决定哪些模型参与、各自承担什么角色,以及应把算力投入候选路径、分歧审查还是关键验证,最终仍返回一个统一结果。
阅读白皮书 →耗时取决于任务、推理强度与实际调用路径。在三项可与 Max 1.0 比较的评测中,Max 2.0 的单题耗时降低 33.3%–50.0%。与其他模型比较时,各任务的速度和质量取舍不同,可以查看完整结果并测试自己的工作流。
查看成绩、成本与耗时 →可先阅读隐私政策;如需了解数据保留、区域、上游模型、专用资源或 SLA,请联系团队,结合你的业务要求确认适用方案。
联系团队 →