 TM
Fusion Max 2.0 是我们的新一代融合模型,进一步强化办公、文档分析与网页编程能力。它能在多轮 Agent 任务中逐步选择适合的模型,并在关键步骤融合多个模型的不同思路。
在推理、终端操作、专业文档与办公问答等任务中,Fusion Max 2.0 展现出比肩 GPT-6 Astra、Claude Fable 5.1 的顶尖性能,同时大幅降低任务成本。Max 与 Code 系列同步下调价格。现在即可通过自助平台注册并使用。
以 1/6 的成本,超越顶尖模型
成本为该项评测全部任务的总成本(USD);平均时间为每道任务的平均耗时(分钟)。
Terminal Bench 4.0*
GDP.pdf
OfficeQA Pro
GPQA Diamond
Terminal Bench v2.1
XBench ScienceQA
* Terminal Bench 4.0 使用 63 题 CPU-only 子集。对照配置:GPT-6 Astra(max)、Claude Fable 5.1(max with fallback)。
更多模型的成绩与成本
↖ 越靠左上越好:以更低的成本,取得更高的成绩。
虚线连接帕累托前沿,表示不同成本下的最佳成绩。
从 Max 1.0 到 Max 2.0
三项评测 · 对比 Fusion Max 1.0
GPQA Diamond
Max 1.0 94.9% → Max 2.0 95.5%
- 平均时间(分钟)−50%
- 10.5
Terminal Bench v2.1
Max 1.0 86.5% → Max 2.0 89.5%
- 平均时间(分钟)−40%
- 159
XBench ScienceQA
Max 1.0 78.4% → Max 2.0 79.0%
- 平均时间(分钟)−33.3%
- 0.60.4
代际对比覆盖 GPQA Diamond、Terminal Bench v2.1 与 XBench ScienceQA 三项评测。
读懂扫描表格,串起长文档中的线索
办公文档的难点,常常藏在资料里:大量扫描表格中的数字难以辨认,同一项目的口径和版本可能不同;一个问题的答案,也可能散落在几十页 PDF 的文字、图纸与表格中。下面两个案例展示 Fusion 如何读准数据、综合信息,以更低的费用完成更多要求。
在大量扫描表格中,读准数字、找对口径
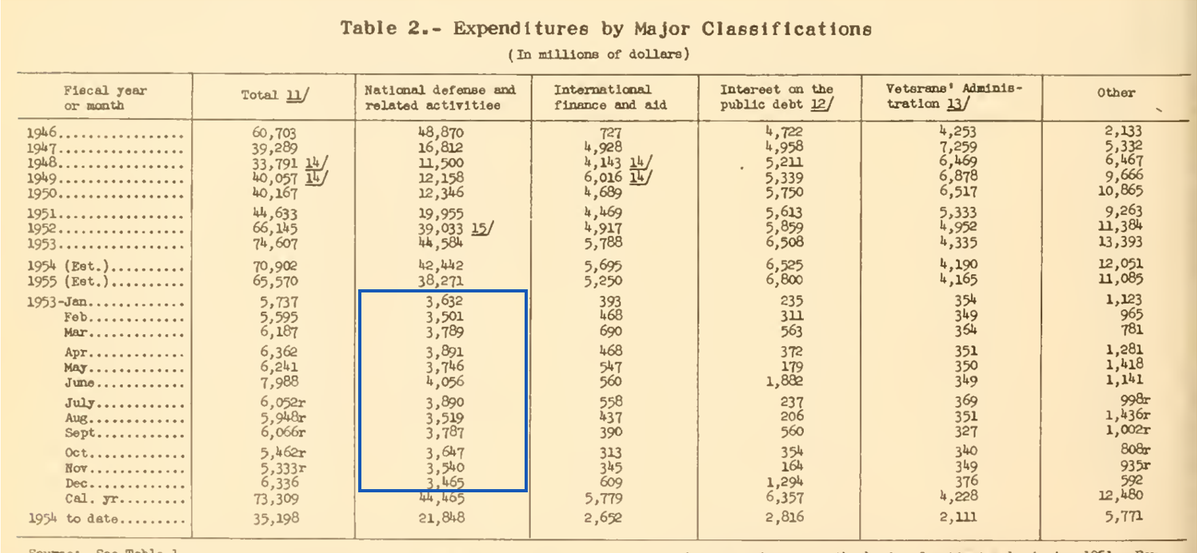
历史公报中的真实任务:跨报表检索,核对两年 24 个月的支出,再完成计算。
表格是扫描图片,读到数字还不够
- 读准模糊数字
密集行列、模糊印刷和脚注增加识别难度;遇到疑点,放大原图再核验。
- 跨表核对版本与口径
从多份报表找到同一统计范围的月度数据,避免漏项或拼接不同版本。
- 按要求汇总,而非照抄合计
逐一核对 24 个月的数据,再统一价格基准计算。
查看完整问题、计算与原表核验
原始问题:美国1953年的国防及相关活动全年支出,比1940年增加了多少?统一按1953年物价比较,以百万美元回答。
将1940年支出换算为1953年价格
44,463 − 5,321.71 = 39,141.29
核对1953年1月时,两张表出现3,632和3,532两个读数。Fusion 放大原文5倍,再与其他表格交叉核对。
1 月支出:3,632 还是 3,532?
核对数字 → 交叉核对 → 加总 12 个月
以上为单个评测任务的运行结果,用于展示处理过程与答案依据;整体能力与成本见上文评测。文件读取与工具执行由评测 Agent 提供。
把一句需求,写成可交互的网页
下面两款浏览器游戏由 Fusion Max 2.0 根据一句话需求生成。它们展示了网页编程中的界面、交互逻辑与状态管理:从角色选择和升级,到碰撞、关卡和分数记录。可以直接试玩生成结果。
一句话提示词
做一个肉鸽游戏
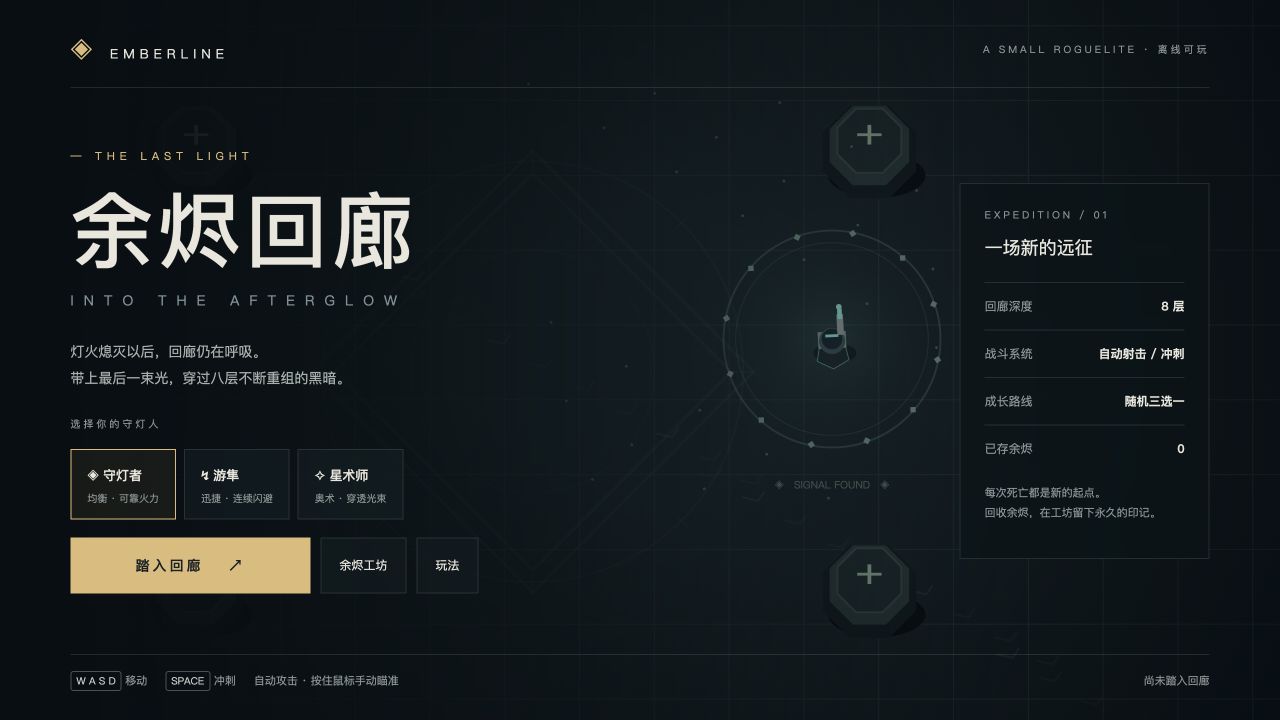
余烬回廊
八层关卡、三位角色,升级时选择新的祝福。
俯视角 Roguelite。选择三位守灯人之一,通过自动攻击和冲刺应对敌人,升级时挑选随机祝福。获得的余烬可用于工坊强化。
游戏内容
- 三位角色与随机祝福
- 八层关卡与 Boss 战
- 工坊成长与构筑系统
- 键盘与触控操作
试玩不保存进度。关闭、切换游戏或滚出游戏区域时,试玩会结束。
一个融合模型,汇聚多种模型所长。
复杂任务需要多轮推理、工具调用和结果判断。随着任务推进,需要的能力也在变化。Fusion 在每一步选择适合当前问题的模型,在关键步骤融合多种解题思路,通过一个模型 API 提供这些能力。
跟随任务进展,选择适合的模型
我们通过大量 benchmark 评测研究不同模型的能力,并将这些知识用于训练自研路由模型。Fusion Max 2.0 使用新一代路由模型,根据当前任务上下文,在多轮 Agent 对话的每一步重新做出选择。
从理解需求、执行操作,到分析工具返回的结果,Fusion 会随任务进展匹配模型的长处,并按需要投入计算资源。
在关键步骤,融合多种解题思路
对于单个模型难以充分解决的关键问题,Fusion 会启用多个模型,从不同角度分析和求解,再综合它们的结论形成答案。
逐步选择模型与关键步骤的模型融合,共同构成 Fusion 的工作方式。你可以通过模型 API,在自己的应用和 Agent 中使用这些能力。
阅读 Fusion 技术白皮书 →Max 与 Code 系列同步降价
| 模型 | 输入 | 缓存输入 | 输出 |
|---|---|---|---|
| Fusion Max2.0 / 1.0 | |||
| Fusion Code1.0 |
输入超过 200K tokens 时适用各模型的长上下文费率。内部模型协作产生的 tokens 不计费。单价与一次任务的总费用不同,任务费用还取决于输入、输出、缓存和调用次数。
查看完整价格 →让 Fusion 处理你的下一个任务
注册自助平台,在 Playground 试用模型,或创建 API Key,将 Fusion 接入现有应用与 Agent。
需要处理文件或执行工具时,由接入的应用或 Agent 提供相应能力。企业团队也可以联系我们,讨论业务评估与接入需求。