 TM
博客 / 模型评测 / DAY ZERO
Fable 5.1 首日实测,那些老问题还在吗?
FUMO Lab 首日实测 Fable 5.1:公开成绩能否复现、fallback 与拒答是否仍在,以及真实代码修复任务的调用成本。
返回博客
- 75.3%Terminal-Bench v2.1 实测成功率,低于 AA 公布的 91.4%。
- 25 / 198GPQA 未交付答案;其中 12 题已开始推理后中断。
- 约 -43%六个代码修复任务中,完成数与 Opus 5 相同,费用更低。
- 仍有限制源码漏洞识别已放宽,渗透测试等任务仍受限。
FUMO Lab 在 Fable 5.1 发布首日,测试了科学问答、真实代码修复和终端任务,重点查看公开成绩能否复现、调用费用的变化,以及仍会触发限制的任务。
01 / 测试范围
本次测了什么
本轮包括三套公开测试集,以及一组开源项目 bug 修复任务。
| 评测 | 本轮规模 | 主要测什么 |
|---|---|---|
| GPQA Diamond | 198 题 | 物理、化学、生物领域的高难度科学推理。题目由领域专家编写,要求结合专业知识完成判断和推导。 |
| XBench ScienceQA | 公开集 100 题 | 跨学科专业知识及其应用,观察模型能否理解概念与题目条件,并给出完整答案。本轮使用等价性评测口径。 |
| Terminal-Bench 2.1 | 89 个任务 | 在终端环境中连续完成配置、调试与数据处理,最终以可执行测试验证结果。 |
| 开源项目 bug 修复 | 6 个任务 | 在不同编程语言的真实代码库中理解问题、定位并修复 bug,同时记录调用费用。 |
02 / 成绩复现
Artificial Analysis 上的高分,本轮没有完全复现
Artificial Analysis(AA)公布的 Terminal-Bench 2.1 成绩为 91.4%。我们的测评中 89 个任务通过 67 个,成功率为 75.3%;其中 8 个因供应商 TOS 403 未取得有效评分,剔除后为 82.7%。
这一成绩和 Qwen3.8 Max 相同,低于 GLM-5.3、Kimi K3、GPT-5.6 Sol 等模型。查看 AA 评测结果
同一个模型,公开榜单与实际接入仍可能得到不同结果。运行条件、fallback 与供应商限制都是成绩的一部分。
这一差距主要来自两次评测的运行条件:AA 启用了官方默认 fallback,而我们的测试通过 OpenRouter 固定到 Google Vertex 运行,并出现了拒答和超时。
03 / 拒答与 FALLBACK
25 道科学题没拿到答案,12 道在推理后中断
普通科学问答仍会触发限制,而且可能在推理开始后才被拦住。
GPQA Diamond 的 198 题中,Fable 5.1 答对 165 题、答错 8 题,另有 25 题没有交付答案,占全部题目的 12.6%。已作答部分的准确率达到 95.38%,按全部题目计算则为 83.33%。未交付的题目比答错的题目还多。
如果算上 fallback 的结果,成绩为 93.9%,与 Kimi K3 和 Qwen3.8 Max 持平,略低于 GPT-5.6 Sol、Gemini 3.7 Flash 和 Grok 4.6。
这 25 题集中在生物和化学:14 题涉及生物或生物医学,11 题涉及有机化学,包含遗传学、分子机制和化学反应等内容。运行记录显示,13 题在正式作答前被拦截,另外 12 题已经展开推理,却未能输出最终答案。
Fable 5.1 在 XBench ScienceQA 中也出现了重复空答。四道涉及鲨鱼纳米抗体、空间转录组、组蛋白乳酰化和斑马鱼遗传比例的题,两次运行都没有给出最终答案。至少在这几道题上,重新问一次没有解决问题。
官方仍为 Fable 5.1 保留安全分类器。触发限制后,Claude 产品可能切换到其他模型;API 用户需要配置 fallback,才能让备用模型继续处理。拒答和已经完成模型切换是两种不同结果,可以通过响应中的模型标识和切换记录确认。官方 fallback 说明
本轮 Terminal-Bench 中,7 个最终超时的任务累计出现 18,655 次拒答。框架把空回复当成 JSON 解析错误,继续请求同一模型。这些重复请求消耗了时间,也放大了记录费用,不能用于估算模型正常求解的成本。
04 / 成本
缓存降价,任务账单未必下降
Fable 5.1 的标准输入、输出价格与 Fable 5 相同:每百万 token 分别为 $10 和 $50。缓存读取从 $1 降到 $0.25,降幅 75%。长对话和 agent 任务反复使用已有上下文时,可以受益于这次降价。官方定价说明
但输出量也会影响最终账单。AA 的测试中,Fable 5.1 在 max 推理档的输出 token 用量约为 Fable 5 的 1.7 倍,单任务成本从 $3.14 升至 $3.76,约增加 20%。改用 xhigh 档,单任务成本降到 $2.72,Intelligence Index 得分从 66 降至 65。
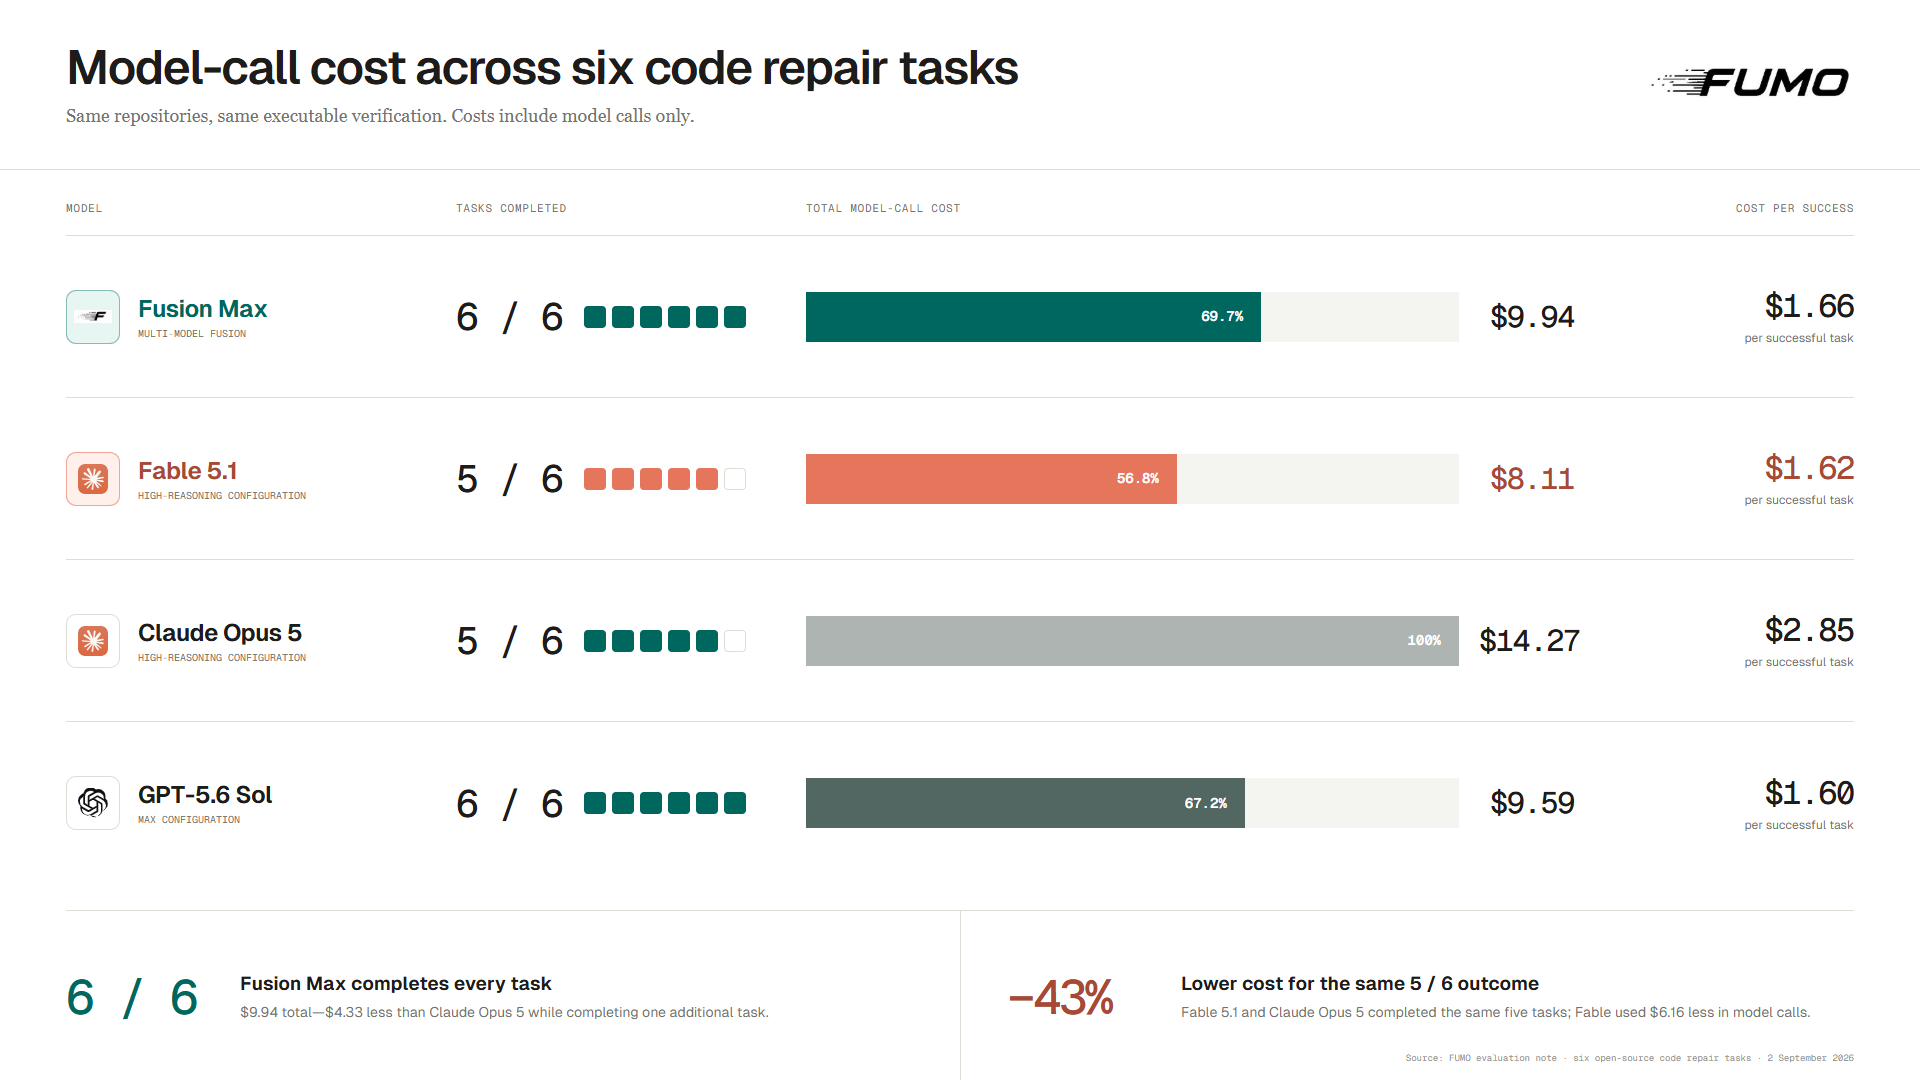
这六道 bug 修复题来自不同编程语言的开源项目,修复是否完成以可执行验证结果判定。跨语言取样扩大了测试覆盖,但不能单凭这一点排除模型曾见过相关源码或补丁。
Fable 5.1 和 Opus 5 完成了相同的五个任务,Fable 的费用低约 43%。费用只统计模型调用。
| 模型 | 完成任务 | 总调用费用 | 每个成功任务 |
|---|---|---|---|
| Fable 5.1 | 5 / 6 | $8.11 | $1.62 |
| Claude Opus 5 | 5 / 6 | $14.27 | $2.85 |
| GPT-5.6 Sol | 6 / 6 | $9.59 | $1.60 |
GPT-5.6 Sol 比 Fable 多花 $1.48,完成全部六题,摊到每个成功任务上的费用略低。Fable 在两档高强度推理配置下都完成 5 / 6,费用均约 $8.10,提高档位没有增加任务成功率。
05 / CYBER
Cyber 的使用范围有所扩大
源码漏洞识别已经放宽,渗透测试等限制仍在。官方当前公布的边界如下:
| 任务类型 | Fable 5.1 的官方使用边界 |
|---|---|
| 识别源代码中的软件漏洞 | 已放宽,可用于此类任务 |
| 渗透测试、漏洞利用生成、基于二进制的漏洞扫描 | 仍受限制 |
| 双用途生物、化学研究问题 | 仍可能转交 Opus 模型 |
使用条件也有变化。官方默认仍要求保留数据 30 天用于安全监测,但符合条件的企业客户已有例外安排,包括 Enterprise Frontier Safeguards 可用前的零数据保留选项。实际接入时,需要结合账户资格和供应平台确认适用条件。官方数据保留说明
06 / 方法
评测说明
关于 Fable 5.1 的更多评测细节,欢迎访问我们的 Research 页面。
本文中的测试完全由 FUMO Lab 自费运行。GPQA 共 198 题;XBench ScienceQA 使用 100 题的等价性评测口径;代码修复共 6 个任务;Terminal-Bench 2.1 共 89 个任务,使用 Harbor 0.20、Terminus-2 和官方规定的超时时间。
跑了将近一天后,这次评测使用的账号被封了。
- 开始零星拒答
少量任务没有返回可解析的答案。
- 随后拒答增多
content_filter/refusal 开始反复出现。
- 最后TOS 403
调用无法继续,整轮评测被迫结束。
回头看任务列表,里面有 DNA 拼接、蛋白质组装,还有一批生物和化学问答。我们在跑公开基准,供应商的安全检查也在全程运行。具体触发了哪条规则,供应商没有告诉我们;这些题目、反复重试与最终封禁之间的关系,也还无法确认。
模型测完了,账号也没了。FUMO Lab
FUMO Lab 是一家位于新加坡的前沿 AI 实验室,研究多模型协作、交叉验证和计算资源分配。我们持续开展模型评测与行为分析,关注模型在具体任务中的表现、失败原因和使用成本。